小显卡跑Qwen2.5-Coder做代码补全
1 前言
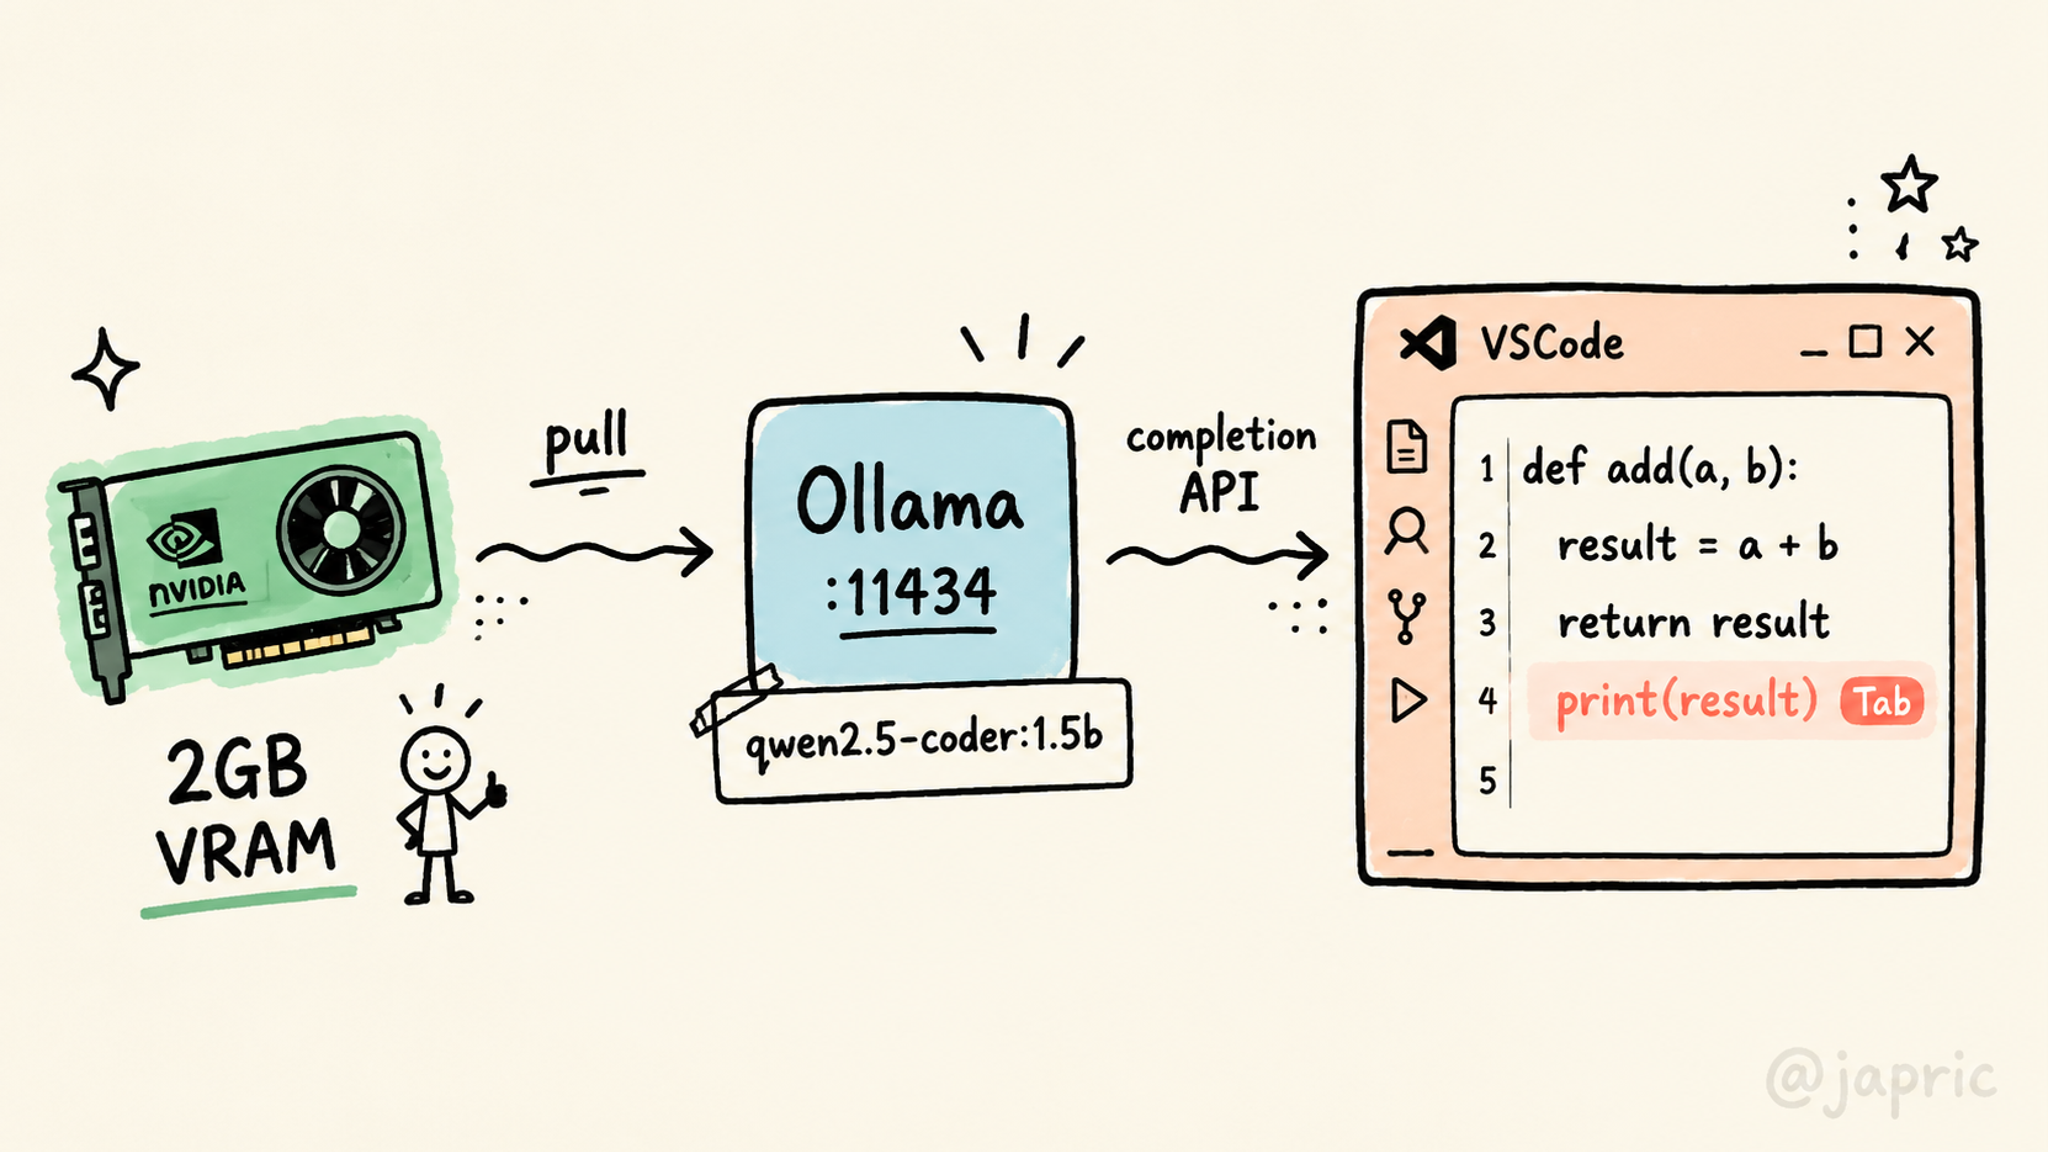
对于普通消费级PC,就算只有2GB显存,也可以用本地显卡推理Qwen2.5-Coder,并通过Continue插件在VSCode里获得可靠的Tab补全。
2 前置条件
机器系统不限,Linux、macOS、WSL2任一都可以。需要一张NVIDIA显卡,型号无所谓,2GB显存也能跑1.5B的Q4量化版本。系统上要已经装好NVIDIA驱动和CUDA,VSCode里要装好Continue插件(在市场里搜Continue,选中continuedev.continue)。笔者的显卡驱动版本575.64.03,显存只有2GB,跑1.5B Q4够用。驱动是否OK用一条命令就能确认:
1
nvidia-smi
能打印出表格即可。
3 安装Ollama
官方一行命令安装:
1
curl -fsSL https://ollama.com/install.sh | sh
服务起来后验证版本和监听端口:
1
2
ollama --version
ss -tlnp | grep 11434   # 应该看到 127.0.0.1:11434,只监听本机
Ollama默认监听127.0.0.1,本机外网访问不到,无需额外加固。
4 下载Qwen2.5-Coder量化模型
1.5B的Q4_K_M量化版权重约1.1GB,最适合小显存机器做补全:
1
ollama pull qwen2.5-coder:1.5b
如果之前自己导入过gguf,也可以直接拉自己那个:
1
ollama pull qwen2.5_coder-1.5b
验证一下能跑:
1
2
ollama list
ollama run qwen2.5-coder:1.5b "def fib(n):"
交互里按Ctrl+D退出。
5 做一个全显存变体让推理更稳(可选)
默认tag会让Ollama自动把部分层卸到CPU,小显存机器上KV cache一大就容易被切到CPU/swap。如果显存能装得下权重加一点KV cache(1.5B Q4大约需要1.4GB显存),可以建一个:allgpu变体强制全部层上GPU:
1
2
3
4
5
6
ollama show qwen2.5-coder:1.5b --modelfile > /tmp/Modelfile.allgpu
cat >> /tmp/Modelfile.allgpu <<'EOF'
PARAMETER num_ctx 4096
PARAMETER num_gpu 32
EOF
ollama create qwen2.5-coder:1.5b:allgpu -f /tmp/Modelfile.allgpu
num_ctx 4096对补全足够(补全场景一次最多几百token)。num_gpu 32强制把所有层(含embedding/output)放到GPU。
验证是否全在GPU:
1
2
ollama run qwen2.5-coder:1.5b:allgpu "ping" /bye
ollama ps
ollama ps输出的PROCESSOR列应该显示100% GPU。
6 配置Continue
Continue 1.2.x的配置文件在~/.continue/config.yaml。最小可用配置:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
name: Local Coder
version: 1.0.0
schema: v1
models:
  - name: Qwen 2.5 Coder 1.5b
    provider: ollama
    model: qwen2.5-coder:1.5b:allgpu
    roles:
      - autocomplete
      - chat
    defaultCompletionOptions:
      maxTokens: 128
  - name: Autodetect
    provider: ollama
    model: AUTODETECT
    roles:
      - autocomplete
      - chat
      - edit
      - apply
context:
  - provider: code
  - provider: docs
  - provider: diff
  - provider: terminal
  - provider: problems
  - provider: folder
  - provider: codebase
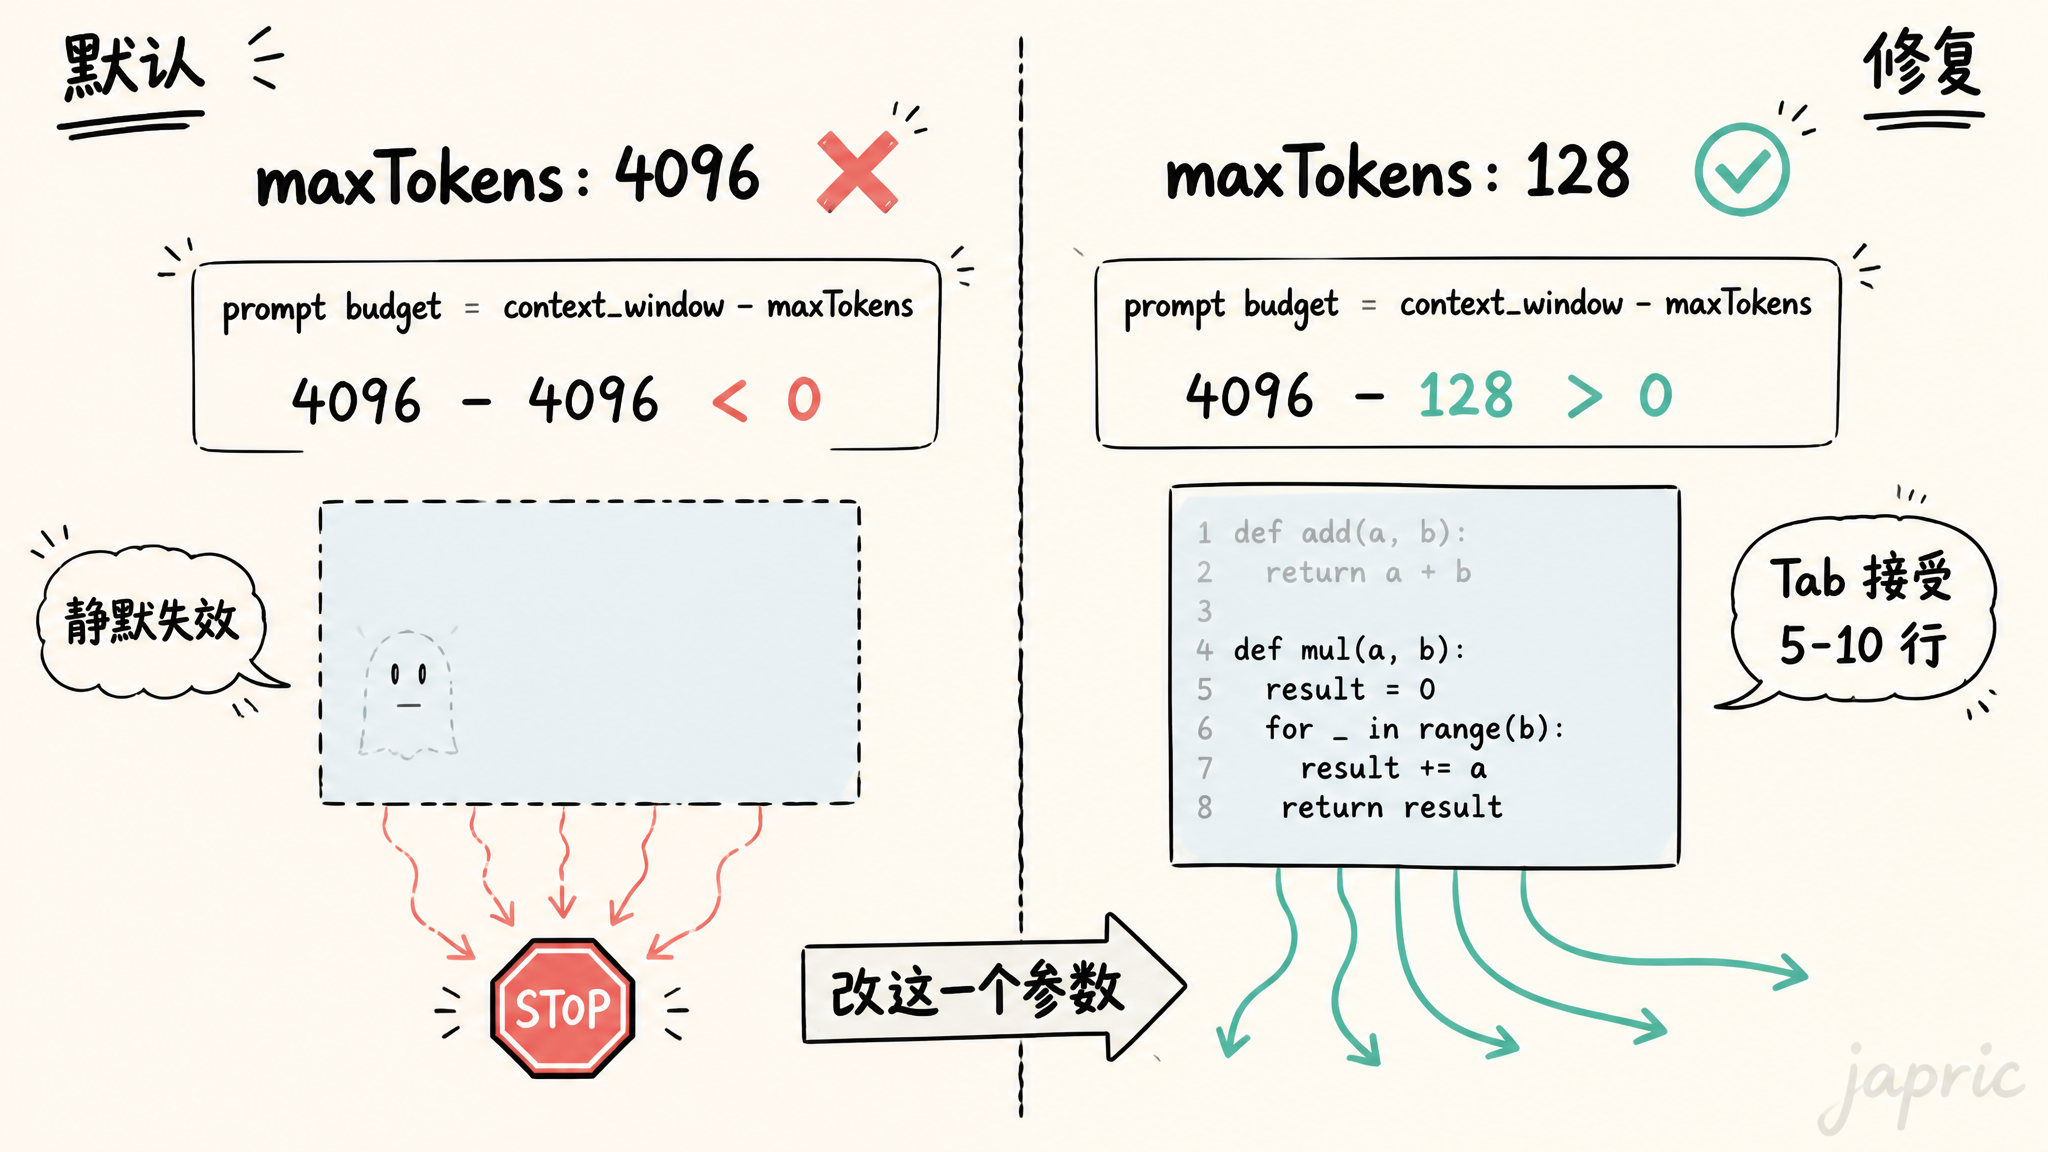
几个关键点要说明。provider: ollama让Continue直接走http://localhost:11434,不用再单独写URL。roles: [autocomplete, chat]把它同时注册成补全和聊天模型。必须显式设defaultCompletionOptions.maxTokens: 128——Continue默认maxTokens=4096,这个值会让它的prompt预算算式变成负数,裁剪到空,补全静默失效。128对补全绰绰有余,大约能出5–10行代码。如果不建:allgpu变体,把model名换成普通的qwen2.5-coder:1.5b即可,此时Ollama会自动分层,速度略慢但稳定性更好。
7 笔者的实际配置
前面给的是最小可用配置,这里把笔者本机真正在用的Modelfile和Continue配置贴出来供参考。Modelfile来自ollama show qwen2.5_coder-1.5b:allgpu --modelfile的输出(TEMPLATE那一大段是Qwen默认的chatml模板,省略不贴):
1
2
3
4
5
6
7
8
9
10
11
12
# Modelfile generated by "ollama show"
# To build a new Modelfile based on this, replace FROM with:
# FROM qwen2.5_coder-1.5b:allgpu

# TEMPLATE 部分是Qwen的chatml模板,ollama show里能看到,这里省略
SYSTEM You are Qwen, created by Alibaba Cloud. You are a helpful assistant.
PARAMETER num_gpu 32
PARAMETER repeat_penalty 1.05
PARAMETER temperature 0.7
PARAMETER top_k 20
PARAMETER top_p 0.8
PARAMETER num_ctx 4096
num_gpu 32和num_ctx 4096是第5节里手动加的,其余repeat_penalty/temperature/top_k/top_p是Qwen2.5-Coder基础模型自带的默认参数。
本地部分在用的配置(节选自~/.continue/config.yaml,省略在线API模型):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
  - name: Qwen 2.5 Coder 1.5b AllGPU
    provider: ollama
    model: qwen2.5_coder-1.5b:allgpu
    roles:
      - autocomplete
      - chat
    defaultCompletionOptions:
      maxTokens: 128
  - name: Autodetect
    provider: ollama
    model: AUTODETECT
    roles:
      - autocomplete
      - chat
      - edit
      - apply
Autodetect那条让Continue自动走Ollama默认模型做edit/apply,不用单独再给它配model名。实际使用时本地的:allgpu变体主要兜底断网或离线场景,在线模型延迟和上下文都更好。
8 在VSCode里选择模型并验证
先重载窗口让Continue重新读配置:Ctrl+Shift+P调出命令面板,执行Developer: Reload Window。然后打开Continue侧边栏,在模型下拉里选Qwen 2.5 Coder 1.5b。打开任意代码文件,光标停在一行结尾等150–300ms,应当能看到灰色补全提示,按Tab接受。
最小验证例子:
1
2
3
4
5
# helloworld
def hello(): print("Hello, world!")

if __name__ == "__main__":
    █
光标停在那行缩进处,应当补出hello()。
9 性能调优清单
| 现象 | 处理 |
|---|---|
| 补全慢、加热卡 | 降num_ctx(4096 → 2048),或换更小的量化(Q4 → Q3) |
显存不够、oom | num_ctx改成2048,或干脆去掉:allgpu变体用默认分层 |
| 补全质量差 | 在Modelfile里设PARAMETER temperature 0.1、PARAMETER top_p 0.9重build变体 |
| 补全常常带Markdown包裹 | 把Continue的autocomplete template调成chatml风格,或在defaultCompletionOptions加stop: ["\n\n", "``”]` |
| 大文件补不出来 | 切到没用:allgpu的普通tag(Ollama自动给到32768 ctx的视图),或把num_ctx升到8192 |
10 卸载清理
1
2
3
4
ollama rm qwen2.5-coder:1.5b:allgpu
ollama rm qwen2.5-coder:1.5b
sudo systemctl stop ollama
sudo apt remove ollama
~/.ollama和~/.continue是数据目录,按需删除即可。